
hugging face10 min read
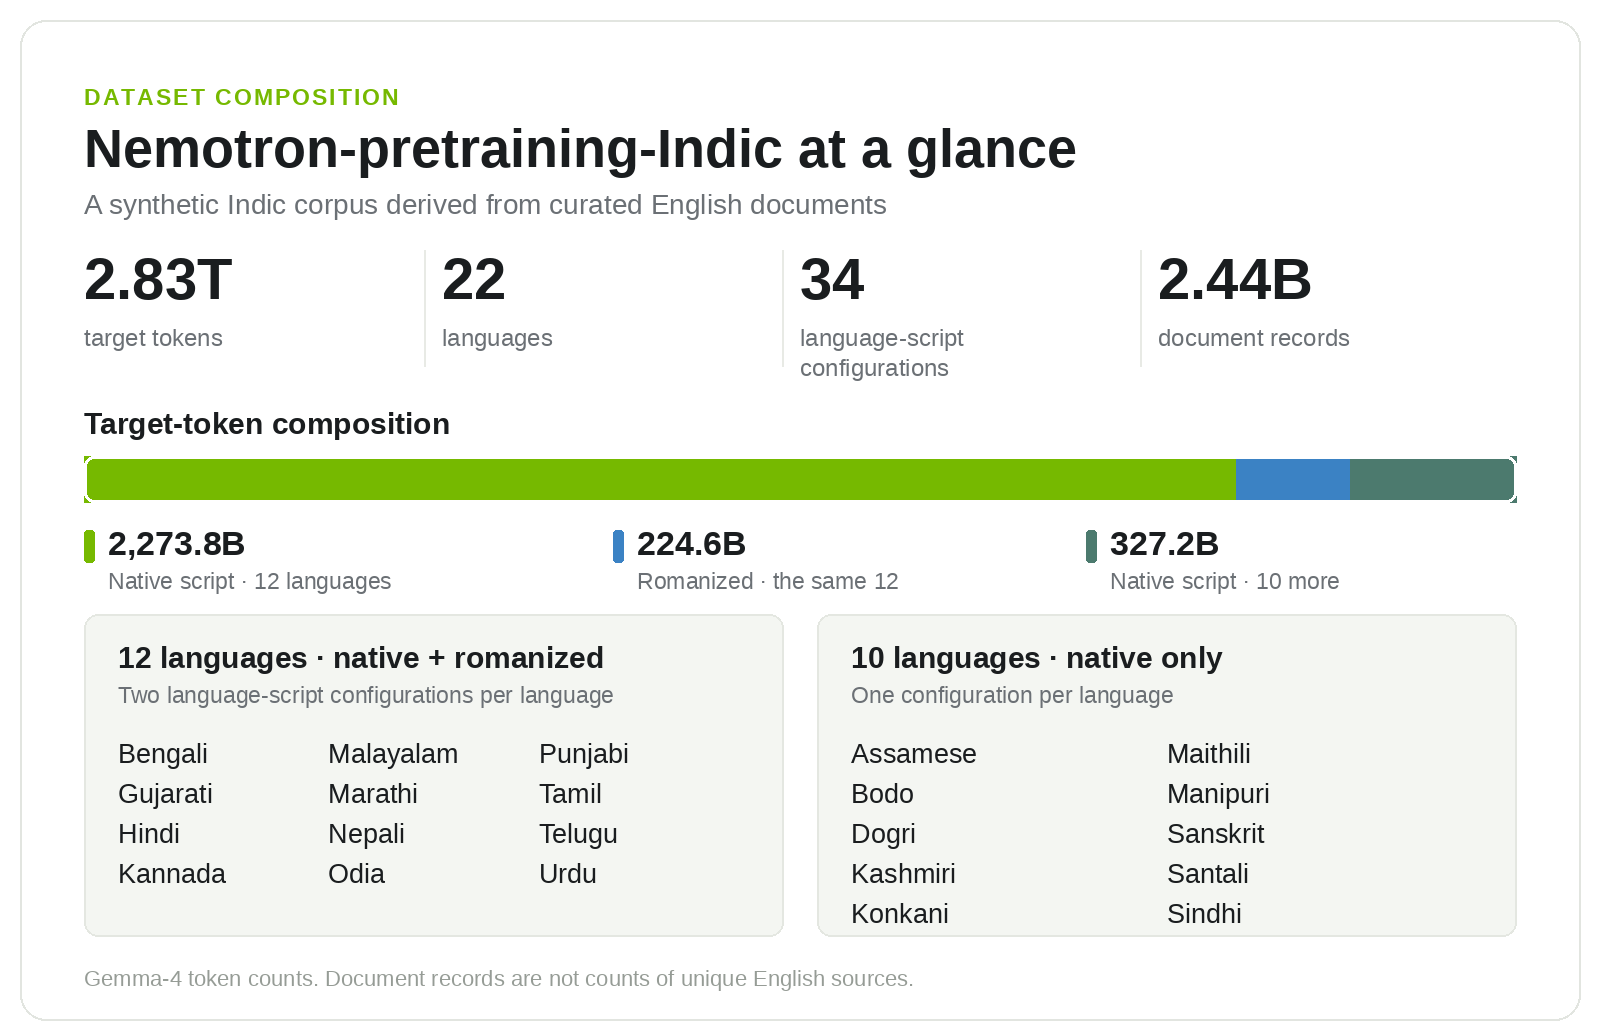
Scaling Indic Pretraining: 2.8 Trillion Tokens and an Open Data Generation Pipeline
Native-script data for 22 languages, romanized data for twelve, and a reusable GPU-accelerated pipeline for translation, quality assessment, and repair.
By Will Jennings, Kiran Praveen, Sriharsha Niverty, Raviraj Joshi, Markus Kliegl, Yev Meyer, Utkarsh Vaidya, Niket AgarwalHugging Face Blog
Read the full story
Originally published by Hugging Face Blog on Oct 16, 2026.
Comments
Sign in to join the discussion.